
Set di dati per l'apprendimento automatico
Acquista e ottieni la licenza per set di dati di addestramento AI premium | Catalogo di dati AI e marketplace di licenze
Il catalogo di dati e il marketplace di licenze AI di Shaip offrono ai team di intelligenza artificiale un'unica fonte per l'acquisto e la concessione in licenza di set di dati di training pre-etichettati e con autorizzazione commerciale, disponibili in formato testo, parlato, immagine, video e multimodale. Ogni set di dati è etichettato manualmente, proviene da fonti etiche ed è pronto per l'addestramento, con la documentazione completa di conformità al GDPR, all'HIPAA e ai requisiti di governance dei dati aziendali.
Che si tratti di perfezionare un modello linguistico complesso, addestrare un sistema di diagnosi sanitaria o accelerare una pipeline di visione artificiale, il catalogo di Shaip copre oltre 10 settori verticali con opzioni di licenza flessibili: acquisto una tantum, accesso in abbonamento o accordi aziendali personalizzati. Richiedi un set di dati di esempio gratuito per verificarne la qualità prima di impegnarti.
Diamo priorità all'approvvigionamento etico dei dati in tutte le nostre operazioni, assicurando uno sviluppo dell'IA responsabile ed equo. Le nostre pratiche rigorose e trasparenti nella raccolta, convalida e gestione dei dati salvaguardano la privacy e mantengono la fiducia sia dei nostri clienti che dei contributori di dati.
Catalogo dati di intelligenza artificiale fisica
Il successo o il fallimento dei programmi di apprendimento robotico dipendono dalla qualità e dalla coerenza dei dati dimostrativi. Il nostro catalogo di IA fisica offre dimostrazioni umane, dati di percezione multimodale ed episodi di azioni e stati robotici raccolti rispetto a una libreria di attività standardizzata, fornendo alle vostre pipeline VLA, umanoidi, di manipolazione e Real2Sim gli episodi puliti e comparabili di cui hanno bisogno per addestrare e valutare in modo affidabile.
Catalogo dati e licenze per l'IA fisica standard:
- Oltre 1,400 scenari di lavoro documentati in 9 ambienti reali (domestico, industriale, commerciale, alberghiero e altro ancora)
- Dimostrazione umana ed episodi di addestramento VLA con stati iniziali e criteri di successo coerenti.
- Video egocentrico e multivista con acquisizione di movimento, posa e destrezza.
- Durata degli episodi da 0.5 a 10 minuti, suddivisi in 4 livelli di difficoltà, incluso l'utilizzo di strumenti.

Catalogo dei dati vocali
Esiste un'ampia varietà di applicazioni comuni per i dati vocali nei progetti di intelligenza artificiale. Ti offriamo grandi quantità di dati di alta qualità pronti per i tuoi prodotti di riconoscimento vocale che si adattano al tuo budget e possono essere ridimensionati man mano che cresci per addestrare i tuoi modelli AI/ML.
Catalogo e licenza dei dati vocali pronti all'uso:
- Oltre 55 ore di dati vocali (50+ lingue/100+ dialetti)
- Oltre 70 argomenti trattati
- Frequenza di campionamento – 8/16/44/48 kHz
- Tipo di audio: spontaneo, sceneggiato, monologo, parole sveglia
- Set di dati audio completamente trascritti in più lingue per conversazioni uomo-uomo, uomo-bot, conversazione con call center uomo-agente, monologhi, discorsi, podcast, ecc.
- Lessici di pronuncia, sia generali che specifici di dominio (es. nomi, luoghi, numeri naturali)

Catalogo dati medici
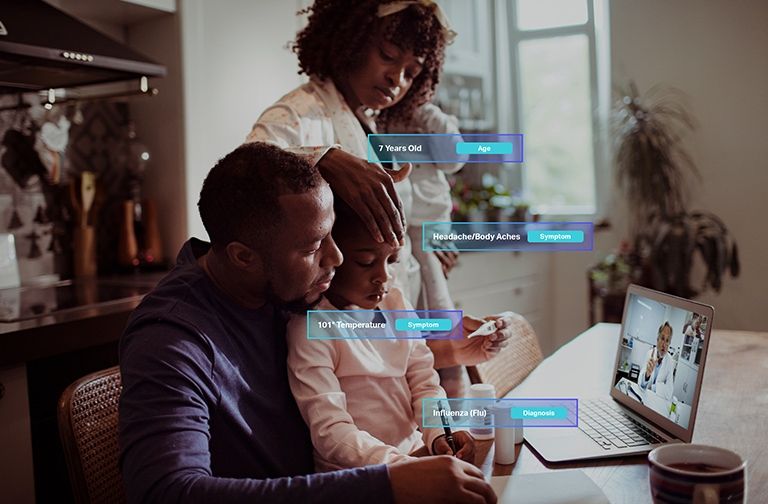
I nostri set di dati del catalogo di dati medici non sono solo enormi, ma hanno dati di qualità standard. Stai certo che i dati che utilizzi sono al sicuro, non identificati e possono essere considerati affidabili per ottenere i risultati più elevati e accurati per la tua iniziativa di intelligenza artificiale, modelli di apprendimento automatico, elaborazione del linguaggio naturale e altri progetti di sviluppo.
Catalogo e licenza di dati medici pronti all'uso:
- Oltre 5 milioni di cartelle cliniche elettroniche e file audio medici in 31 specialità
- 2 milioni di immagini mediche in radiologia e altre specialità (MRI, TC, USG, XR)
- Oltre 30 documenti di testo clinico con entità a valore aggiunto e annotazione di relazioni
Catalogo dati di visione artificiale
Esiste un'ampia varietà di applicazioni comuni per la visione artificiale nei progetti di intelligenza artificiale. Ti offriamo grandi quantità di dati di immagini e video di alta qualità pronti per i tuoi modelli di visione artificiale che si adattano al tuo budget e possono essere ridimensionati man mano che cresci.
Catalogo dati immagine e video e licenze:
- Raccolta di immagini di alimenti/documenti
- Raccolta di video sulla sicurezza domestica
- Raccolta di immagini/video facciali
- Fatture, PO, Ricevute Raccolta documenti per OCR
- Raccolta di immagini per il rilevamento dei danni ai veicoli
- Raccolta di immagini della targa del veicolo
- Collezione di immagini per interni auto
- Raccolta di immagini con il conducente dell'auto a fuoco
- Collezione di immagini relative alla moda
- Raccolta e annotazione di video basati su droni
- Raccolta di video/immagini per disabili
- Collezione di immagini di riferimento
- Raccolta di immagini per la scansione di codici a barre

Catalogo dati testuale
I modelli linguistici di grandi dimensioni e i sistemi NLP necessitano di testi che riflettano il linguaggio reale, i domini reali e le reali variazioni regionali. Il nostro catalogo di dati testuali offre dataset di testo pronti per la licenza in 8 categorie: domande e risposte conversazionali, codice, notizie, testi clinici, testo web grezzo, documenti scansionati, contenuti accademici e di intrattenimento. Sono progettati per il pre-addestramento, la messa a punto, il RAG e la valutazione, e ognuno può essere adattato alle esigenze del vostro progetto.
Catalogo di dati testuali standard e licenze:
- Oltre 170 coppie di domande e risposte create da esseri umani, in inglese e arabo, che coprono i dialetti sauditi, emiratini, egiziani e levantini.
- Oltre 50 milioni di righe di codice in 9 linguaggi di programmazione, molte delle quali con cronologia completa di pull request e commit.
- Archivio di notizie con 975 articoli risalenti al 1999, oltre a feed di notizie in continuo aggiornamento in inglese, spagnolo e arabo.
- Domande e risposte cliniche, riassunti di casi e articoli, disponibili in set oro/argento, con anonimizzazione.
- Corpus di testo arabo grezzo di 20 milioni di parole, più corpus di script di prompt e TTS per il pre-addestramento
- Oltre 1.3 milioni di articoli su riviste scientifiche e oltre 4,100 titoli di libri in 12 discipline scientifiche e ingegneristiche.
- Documenti e moduli reali scansionati (oltre 12 PDF) per l'intelligenza artificiale applicata ai documenti e l'estrazione di informazioni.
- Oltre 90 ore di contenuti sceneggiati tra film, serie TV, animazione e microdrammi per la modellazione narrativa e dei dialoghi.
Set di dati aperti
Attraverso la libreria Shaip di set di dati aperti, il tuo team ha accesso gratuito a un vasto repository di dati AI. Ora puoi sviluppare in modo rapido e accurato i tuoi modelli di IA e ML in base ai tuoi risultati aziendali specifici senza costi associati.
Set di dati aperti disponibili:
- Disponibile in una forma comoda e modificabile
- Vaste categorie di set di dati
- Gratuito per l'uso con i tuoi progetti AI e ML
- Dati gold standard di alta qualità

Sicurezza e conformità


Pianifica una demo per scoprire come Shaip può soddisfare tutti i tuoi requisiti sui dati di formazione.
Dalla raccolta dei dati all'annotazione, alla concessione di licenze e alla convalida, vi aiuteremo ad arrivare sul mercato più velocemente, con dati affidabili.
ContattaciDomande frequenti (FAQ)
1. Che cosa sono le licenze del catalogo dati?
La licenza del catalogo dati consente alle aziende di acquistare o concedere in licenza l'accesso a set di dati selezionati da utilizzare in progetti di intelligenza artificiale. Questi set di dati includono dati di testo, voce, immagini o video, accuratamente preparati per soddisfare requisiti specifici. La licenza garantisce che le aziende possano utilizzare legalmente i dati, nel rispetto degli standard di privacy e conformità.
2. Come vengono raccolti ed etichettati i set di dati di addestramento dell'IA di Shaip?
Shaip raccoglie dati attraverso una rete globale di collaboratori verificati in oltre 60 paesi, utilizzando la piattaforma di raccolta proprietaria di Shaip. Tutti i set di dati sono sottoposti a un controllo di qualità multilivello da parte di annotatori esperti del settore, a verifiche di validazione automatizzate e a una revisione finale manuale prima della consegna. Gli obiettivi di accuratezza dell'etichettatura superano il 95% in tutte le categorie del catalogo.
3. Shaip è in grado di adattare i set di dati alle crescenti esigenze del progetto?
Sì, i set di dati di Shaip sono scalabili. Che abbiate bisogno di piccoli set di dati per i test o di grandi volumi per addestrare modelli di intelligenza artificiale di livello aziendale, la rete globale di Shaip può fornire dati adatti alle esigenze del vostro progetto.
4. Quanto costa ottenere la licenza per i set di dati disponibili in commercio?
Il costo della licenza dipende da fattori come tipo di dati, volume, personalizzazione e diritti di utilizzo. Shaip offre prezzi flessibili per adattarsi a budget ed esigenze di progetto diversi. Contatta il team per un preventivo personalizzato.
5. Posso richiedere un set di dati di esempio?
Sì, Shaip offre set di dati di esempio per aiutarti a valutare la qualità dei dati e la loro pertinenza al tuo progetto. Contatta il team per programmare una demo o richiedere un campione.
6. Dove posso acquistare set di dati di addestramento per l'IA con licenza per uso commerciale?
Il catalogo di dati AI di Shaip offre set di dati pre-etichettati disponibili per la concessione immediata di licenze commerciali in formato testo, parlato, immagine, video e multimodale. Tutti i set di dati includono una chiara documentazione relativa alle licenze commerciali, conforme al GDPR e all'HIPAA, con opzioni di acquisto una tantum, abbonamento annuale o contratto aziendale. Richiedi un campione gratuito per verificarne la qualità prima dell'acquisto.
7. Come posso acquistare set di dati conformi al GDPR e all'HIPAA per l'addestramento di modelli di intelligenza artificiale?
L'intero catalogo di dataset di Shaip è stato creato per soddisfare i requisiti di conformità GDPR e HIPAA. Ogni dataset include la documentazione relativa al consenso, i record di anonimizzazione (per i dati medici), i metadati sulla provenienza dei dati e gli artefatti di conformità pronti per gli audit. Le organizzazioni soggette ai framework GDPR, HIPAA, CCPA o ISO 27001 possono ottenere la licenza per i dataset con la documentazione completa inclusa senza costi aggiuntivi.
8. Quali tipi di dataset multimodali pre-etichettati posso ottenere in licenza da Shaip?
Shaip offre dataset multimodali che combinano dati testuali, vocali, immagini e video, tra cui video egocentrici per l'IA fisica, dataset di dimostrazioni umane per la robotica e corpus combinati di testo e immagini per la messa a punto dell'IA generale. Tutti i dataset multimodali includono metadati, annotazioni a livello di modalità e termini di licenza commerciale. Campioni gratuiti sono disponibili su richiesta.
