Il riconoscimento ottico dei caratteri (OCR) è ormai alla base della scansione delle ricevute, della verifica dell'identità, dell'automazione della fatturazione, della digitalizzazione degli archivi storici e delle app per prendere appunti tramite stilo. Si prevede che il mercato dell'OCR raggiungerà i 32.90 miliardi di dollari entro il 2030, con un tasso di crescita annuo composto (CAGR) del 14.8% (Grand View Research, 2024), e il riconoscimento intelligente dei caratteri (IAC), ovvero la branca dell'OCR dedicata alla lettura della scrittura a mano, è quello che cresce più rapidamente. Che si tratti di analisi di documenti, rilevamento di testo in scene o trascrizione della scrittura a mano, il dataset OCR utilizzato per l'addestramento determina il livello di precisione raggiungibile. Questa guida illustra 22 dataset OCR gratuiti e open source, inclusi i migliori dataset per la scrittura a mano, organizzati per caso d'uso e aggiornati con le versioni più performanti fino al 2024.
Punti chiave
- OCR (riconoscimento ottico dei caratteri): Tecnologia che converte immagini di testi stampati, scene o testi scritti a mano in dati leggibili dalle macchine.
- I set di dati OCR sono suddivisi in cinque gruppi: documenti/moduli, testo di scena, cifre/caratteri, scrittura a mano e multilingue.
- Set di dati OCR di documenti acquisire pagine strutturate come moduli e ricevute; set di dati di testo della scena catturare il testo "in natura".
- IAM, MNIST, ICDAR e SROIE rimangono i benchmark OCR più citati nella ricerca.
- I termini di licenza variano notevolmente: verifica ogni set di dati OCR prima di effettuare un addestramento commerciale.
Cos'è l'OCR (riconoscimento ottico dei caratteri)?
L'OCR è una tecnologia che converte diversi tipi di documenti, come documenti cartacei scansionati, PDF o immagini di testo, in dati modificabili e ricercabili. Funziona così:
- Analisi della struttura del testo in un'immagine
- Suddividere il testo in righe e caratteri
- Convertire questi caratteri visivi in testo leggibile dalla macchina
Gli usi comuni includono:
- Conversione di documenti scansionati in file di testo modificabili
- Digitalizzazione di libri stampati
- Estrazione di testo dalle foto
- Conversione di prescrizioni scritte a mano in testo digitale
- Riconoscimento targa
Come si sceglie il dataset OCR più adatto?
La scelta di un dataset OCR dipende da quattro fattori: tipo di testo, ambiente di acquisizione, granularità dell'annotazione e licenza. L'OCR su documenti stampati richiede dati di addestramento diversi rispetto al testo scritto a mano in corsivo o al testo curvo su scene. I dataset di documenti sono adatti a fatture, moduli e ricevute; i dataset di testo su scene sono adatti alla segnaletica e alla lettura di prodotti; i dataset di scrittura a mano sono adatti a note, manoscritti e input da stilo. Le annotazioni a livello di parola e di riga supportano pipeline OCR complete, mentre i set a livello di carattere sono adatti a baseline di classificazione. Verificare sempre i termini della licenza, poiché alcuni dataset OCR sono solo per la ricerca o richiedono la registrazione.
Quali sono i migliori dataset per l'OCR di documenti e moduli?
I dataset di OCR per documenti addestrano modelli per analizzare pagine strutturate come fatture, moduli, ricevute e documenti d'identità. Questi dati alimentano l'automazione dei documenti aziendali e l'estrazione di informazioni chiave-valore.
- FUNSD — 199 moduli scansionati e annotati, con un aspetto realistico e ricco di dettagli. Il punto di riferimento standard per la comprensione dei moduli e l'estrazione di coppie chiave-valore.
- SROIE — Dataset ICDAR 2019 di circa 1,000 scontrini scansionati, che supporta il rilevamento del testo, il riconoscimento e l'estrazione di informazioni in un unico set.
- CAVO — Un dataset consolidato di ricevute, creato per l'analisi post-OCR, con etichette dettagliate a livello di campo per l'automazione di fatture e ricevute.
- Xfund — Estensione multilingue di FUNSD che copre sette lingue (tedesco, spagnolo, francese, italiano, giapponese, portoghese, cinese) con 199 pagine ciascuna. Ideale per l'intelligenza artificiale applicata a documenti multilingue.
- DDI-100 — Circa 100,000 immagini di documenti distorti per il rilevamento e il riconoscimento in condizioni di degrado reali come inclinazione, sfocatura e rumore.
Quali sono i migliori dataset per il riconoscimento ottico dei caratteri (OCR) di testi in scene?
I dataset Scene-Text OCR addestrano i modelli a leggere il testo in immagini naturali come cartelli, prodotti e scene di strada. Questi sono essenziali per l'OCR in contesti reali, dove gli sfondi sono complessi e ricchi di dettagli.
- Lettura robusta ICDAR — La famiglia di riferimento alla base della maggior parte delle ricerche sulla descrizione di scene e testi, comprese le sfide Focused e Incidental Scene Text con riquadri di delimitazione a livello di parola e trascrizioni.
- Testo COCO — Annotazioni di testo su larga scala sovrapposte a immagini MS-COCO. Efficace per il rilevamento di testo su larga scala in scene naturali.
- Testo completo — È specializzato nel riconoscimento di testi curvi e con orientamento arbitrario, un punto debole noto dei modelli OCR più datati.
- SVT (Testo di Street View) — Immagini di testo tratte da Google Street View, spesso a bassa risoluzione e con elevata variabilità. Disponibili tramite i mirror di Papers with Code.
- HierText — Annotazione gerarchica da paragrafo a riga a parola, che copre sia il testo manoscritto che quello stampato della scena. Utile per l'OCR con riconoscimento del layout.
Quali sono i migliori dataset per il riconoscimento ottico dei caratteri (OCR) di cifre e caratteri?
I dataset OCR di cifre e caratteri vengono utilizzati per addestrare modelli a riconoscere singoli simboli in contesti controllati. Questi rappresentano i punti di partenza standard per le classificazioni di riferimento.
- MNIST — 70,000 immagini di cifre scritte a mano in scala di grigi. Il test di riferimento più rapido per la validazione di un classificatore di cifre.
- EMNIST — Estende MNIST con 814,255 lettere e cifre scritte a mano derivate dal database speciale NIST 19.
- SVHN (Numeri civici di Street View) — Oltre 600,000 immagini reali di cifre di numeri civici. Un pratico passo avanti rispetto a MNIST per condizioni di rumore.
- Chars74K — 74,107 immagini che ritraggono caratteri inglesi e kannada, tratte da immagini naturali e font digitali.
- Database speciale NIST 19 — Oltre 810,000 immagini di caratteri scritti a mano da 3,600 autori. La fonte da cui derivano molti benchmark OCR per la lingua inglese.
Quali sono i migliori dataset di scrittura a mano per l'OCR?
I dataset di scrittura a mano vengono utilizzati per addestrare i modelli OCR a leggere testi manoscritti in corsivo, stampatello e storici. I dataset di scrittura a mano aperti più validi rimangono i benchmark più citati per il riconoscimento del testo scritto a mano (HTR).
- Database di scrittura a mano IAM — Il gold standard della scrittura a mano inglese, con 13,353 righe di testo di 657 autori. Ancora oggi il dataset di scrittura a mano più citato nella ricerca OCR del 2024-2025.
- IAM-OnDB — La versione online di IAM per il riconoscimento della scrittura a mano, che acquisisce i dati di traiettoria. Il dataset canonico per il riconoscimento della scrittura a mano tramite stilo e tablet.
- Documenti Bentham — Trascrizioni di manoscritti storici inglesi del filosofo Jeremy Bentham. Il principale punto di riferimento per il riconoscimento ottico dei caratteri (OCR) di manoscritti storici, accessibile tramite Transkribus.
- GNHK (GoodNotes Handwriting Kollection) — Un dataset del 2021 di appunti manoscritti in inglese, non vincolati, provenienti da situazioni reali. Più simile a dati di produzione disordinati che a dati IAM (Identity and Access Management) "puliti" come in un laboratorio.
Quali sono i migliori dataset OCR multilingue e non latini?
I dataset OCR multilingue addestrano i modelli su scritture diverse dall'inglese, tra cui il cinese, l'arabo e la notazione matematica. Questi sono essenziali per il riconoscimento globale di documenti e scrittura a mano.
- CASIA-HWDB — Il benchmark OCR cinese standard, con 1.17 milioni di campioni di caratteri scritti a mano da 1,020 autori.
- KHATT — 1,000 moduli arabi scritti a mano da 1,000 autori diversi, scansionati a diverse risoluzioni. Il dataset OCR arabo aperto più completo.
- CROHME — Competizione sul riconoscimento di espressioni matematiche scritte a mano online: oltre 10,000 espressioni con più di 101 simboli matematici, sia in versione online che offline. Essenziale per l'OCR di equazioni scritte a mano.
Quali sono le insidie più comuni nell'utilizzo di dataset OCR gratuiti?
Tre sono le insidie in cui incappano la maggior parte delle squadre.
Incompatibilità di dominio: addestrare il sistema su IAM o COCO-Text puliti e implementarlo su fatture stropicciate garantisce una scarsa precisione.
Limitazioni relative alle licenze: diversi dataset OCR relativi a scene e testi, nonché a dati storici, sono destinati esclusivamente alla ricerca o richiedono la registrazione prima dell'uso commerciale.
Lacune nelle annotazioni: molti dataset OCR non dispongono dei metadati di impaginazione, dei riquadri di delimitazione a livello di riga o delle etichette di campo necessari ai sistemi di produzione.
Immaginate un'azienda di logistica di medie dimensioni che automatizza la lettura delle etichette di spedizione. L'addestramento con immagini di testo pubbliche permette loro di raggiungere l'80% dei risultati di riferimento, ma le etichette reali, con riflessi e pieghe, fanno scendere la percentuale al 58%. Per colmare questo divario è stata necessaria l'annotazione mirata di 6,000 immagini di etichette specifiche del settore prima del lancio.
Vantaggi e sfide dei set di dati open source
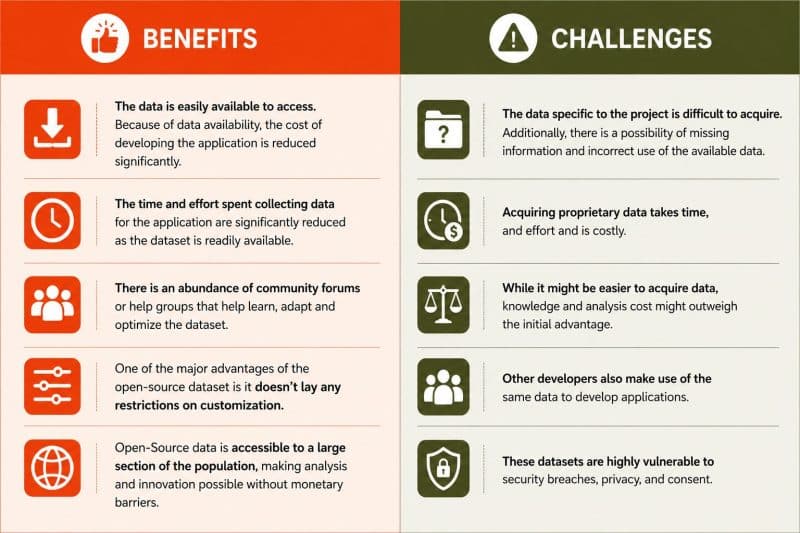
Le aziende devono mettere a confronto vantaggi e sfide per capire se devono optare per dati free-to-use per le loro applicazioni ML.
Vantaggi
- I dati sono facilmente accessibili. Grazie alla disponibilità dei dati, il costo di sviluppo dell'applicazione è notevolmente ridotto.
- Il tempo e lo sforzo dedicati alla raccolta dei dati per l'applicazione sono notevolmente ridotti poiché il set di dati è prontamente disponibile.
- C'è un'abbondanza di forum della comunità o gruppi di aiuto che aiutano ad apprendere, adattare e ottimizzare il set di dati.
- Uno dei principali vantaggi del set di dati open source è che non pone alcuna restrizione alla personalizzazione.
- I dati open source sono accessibili a un'ampia fascia della popolazione, rendendo possibile l'analisi e l'innovazione senza barriere monetarie.
Le sfide
- I dati specifici del progetto sono difficili da acquisire. Inoltre, esiste la possibilità di informazioni mancanti e di un uso non corretto dei dati disponibili.
- L'acquisizione di dati proprietari richiede tempo, fatica ed è costosa
- Sebbene possa essere più facile acquisire dati, la conoscenza e il costo dell'analisi potrebbero superare il vantaggio iniziale.
- Anche altri sviluppatori utilizzano gli stessi dati per sviluppare applicazioni.
- Questi set di dati sono altamente vulnerabili alle violazioni della sicurezza, alla privacy e al consenso.
In che modo Shaip supporta i progetti di riconoscimento ottico dei caratteri (OCR) e di riconoscimento della scrittura a mano?
I servizi di dati di training OCR di Shaip combinano la curatela di dataset aperti con la raccolta di dati personalizzati in oltre 60 lingue, spaziando da documenti stampati a mano, ricevute e documenti d'identità. I flussi di lavoro di annotazione di Shaip aggiungono i livelli mancanti nei dataset OCR pubblici: riquadri di delimitazione a livello di riga, etichette a livello di campo, controllo qualità della trascrizione e metadati dell'autore.
Conclusione
I 22 dataset OCR sopra elencati offrono una base open-source completa per il riconoscimento di documenti, testo in scene, cifre, scrittura a mano e lingue diverse, adatta al 2026. Iniziate con il dataset OCR più adatto al vostro tipo di testo e all'ambiente di acquisizione, validatelo confrontandolo con un campione di dati reali e prevedete un budget per l'annotazione personalizzata al fine di colmare le lacune specifiche del settore. Questa combinazione consente di ottenere risultati più rapidamente rispetto alla creazione da zero.